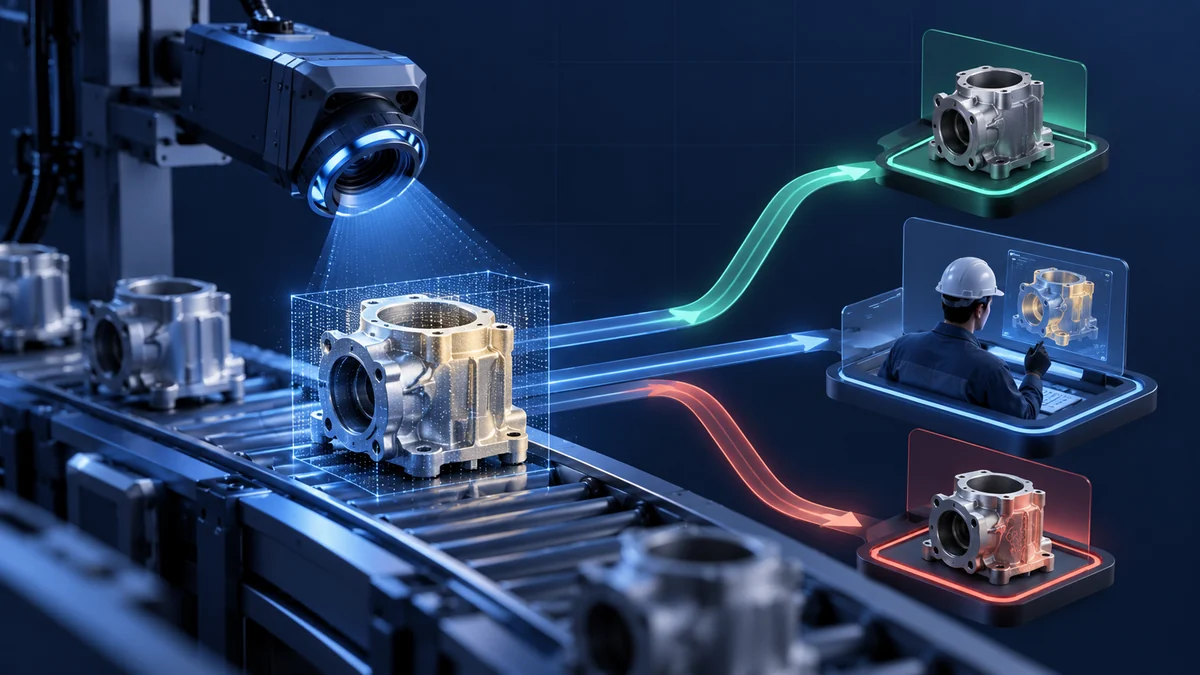
공장 검사 모델이 부품의 불량 가능성을 0.51이라고 표시했다고 합시다. 이 제품을 바로 폐기해야 할까요, 통과시켜야 할까요? 둘 중 하나를 강제로 고르면 정상 제품을 버리거나 불량 제품을 놓칠 수 있습니다. 사람은 애매한 경우 추가 촬영이나 재검을 요청할 수 있는데, AI 시스템은 종종 ‘합격/불합격’ 두 버튼만 갖습니다.
판정 보류는 모델이 약해서 생긴 예외가 아니라 운영 설계의 일부입니다. 자동화해도 되는 범위와 사람 검토가 필요한 범위를 데이터와 현장 비용으로 정해야 합니다.
모델 점수는 곧바로 확률이 아니다
분류 모델이 내놓은 0.9라는 점수가 ‘열 건 중 아홉 건이 실제로 불량’이라는 의미가 되려면 보정이 맞아야 합니다. 학습 데이터나 클래스 균형에 따라 점수가 지나치게 확신에 차 있을 수 있습니다. scikit-learn 확률 보정 가이드는 비슷한 예측 확률을 받은 사례에서 실제 발생 비율을 비교하는 보정 곡선과, 학습 데이터와 분리한 보정 데이터의 중요성을 설명합니다.
검사 라인에서는 제품 종류, 카메라, 조명, 교대 시간별로 점수 분포가 달라질 수 있습니다. 전체 평균만 맞아도 특정 설비에서는 위험할 수 있으므로 주요 조건별 보정 상태를 확인합니다. 정답 라벨 자체가 애매한 결함도 있으니 검토자 간 의견 차이를 별도로 관리합니다.
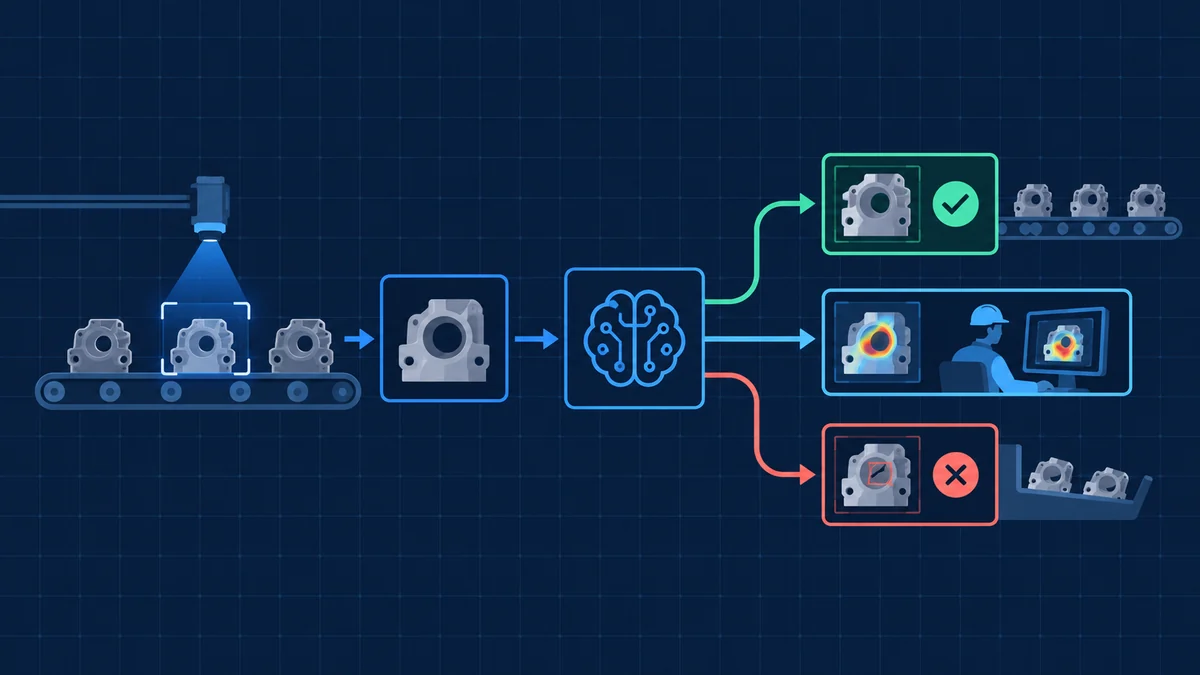
세 갈래 결정을 설계한다
명확히 정상인 제품은 자동 통과, 명확한 불량은 별도 확인 또는 격리, 그 사이 구간은 사람 검토로 보냅니다. 경계값은 임의의 ‘0.5’로 고정하지 않습니다. 불량을 놓쳤을 때의 고객 피해, 정상 제품을 버리는 비용, 검사자의 검토 용량, 처리 지연을 함께 평가합니다. 안전과 관련된 제품이라면 자동 통과 범위를 더 보수적으로 잡을 수 있습니다.
검토로 보내는 비율이 너무 높으면 현장 인력이 감당할 수 없습니다. 반대로 검토 비율을 낮추겠다고 경계값을 무리하게 바꾸면 미검이 증가할 수 있습니다. 검토율과 자동 판정 대상의 오류율을 함께 제시하고, 품목별로 허용 범위를 합의합니다. ‘정확도 99%’ 한 숫자보다 이 두 값이 실제 운영을 설명합니다.
검토 화면은 점수보다 근거가 필요하다
검토자에게는 원본 이미지, 확대할 결함 영역, 촬영 조건, 모델 버전, 과거 유사 판정, 재촬영 가능 여부가 도움이 됩니다. 모델의 열지도는 참고 자료일 뿐 결함 위치의 증명이라고 과장해서는 안 됩니다. 최종 판단과 이유를 기록하되, 사람이 항상 맞다고 가정하지도 않습니다. 중요한 사례는 이중 검토나 품질 책임자 확인을 둘 수 있습니다.
모델이 보류한 이미지가 학습 데이터로 되돌아갈 때에는 라벨 검증과 개인정보·영업비밀 처리 절차가 필요합니다. ‘보류된 사례’만 모으면 쉬운 정상 사례가 빠진 편향된 데이터셋이 되므로, 자동 통과·불량 판정 사례도 표본 추출해 재검증해야 합니다.
판정 보류 물량이 일시적으로 급증하면 검사자가 밀리고 생산 흐름이 멈출 수 있습니다. 이때는 자동 통과 기준을 임의로 완화하기보다 현장 책임자에게 원인을 알리고 재촬영·추가 검사·임시 수동 처리 중 안전한 경로를 선택하게 해야 합니다.
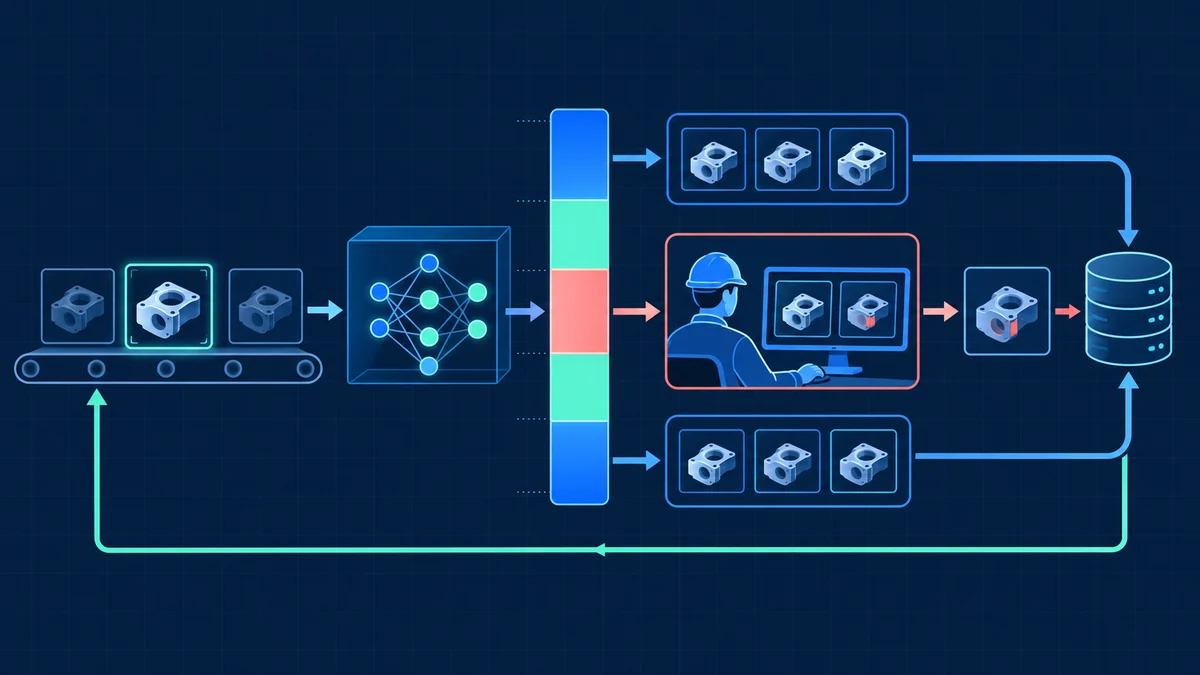
배포 후에도 기준을 다시 확인한다
새 제품이 투입되거나 조명이 바뀌면 기존 보정과 경계값이 더 이상 맞지 않을 수 있습니다. 자동 판정의 샘플 오검·미검, 보류 비율, 처리 지연, 검토자 간 불일치를 관찰합니다. 점수 분포가 급격히 변하면 우선 현장 촬영 환경과 전처리 오류를 점검합니다. 기준을 바꿀 때는 모델 버전과 경계값 버전을 함께 기록해야 과거 결정을 재현할 수 있습니다.
실무 체크리스트
- 독립된 검증 데이터로 점수 보정 상태를 확인한다.
- 미검·오검·사람 검토 비용을 구분한다.
- 자동 통과·보류·불량 기준을 품목별로 정한다.
- 검토자의 처리 용량과 지연을 측정한다.
- 자동 판정 사례도 표본 재검사한다.
현장에서 좋은 AI는 늘 단호하게 대답하는 AI가 아닙니다. 확실한 사례는 빠르게 처리하고, 애매한 사례는 사람에게 넘길 줄 아는 AI가 생산 속도와 품질을 함께 지킬 수 있습니다.
#산업AI #비전AI #불량검출 #판정보류 #확률보정 #사람검토 #HumanInTheLoop #스마트팩토리 #품질관리 #MLOps