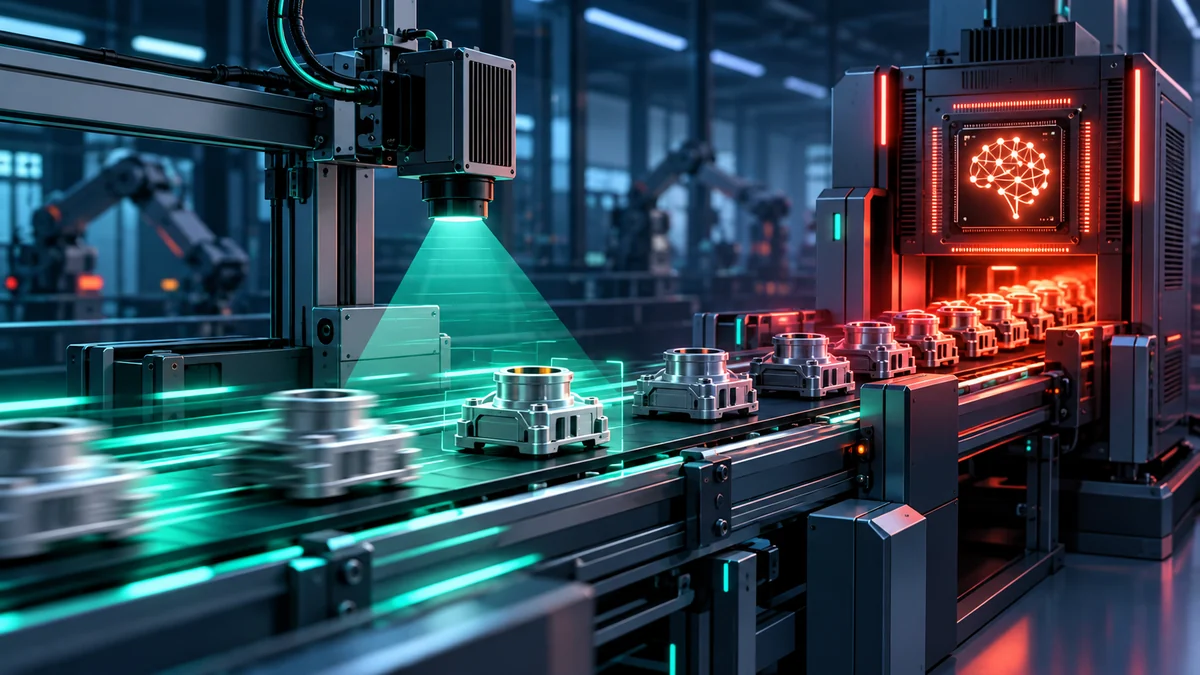
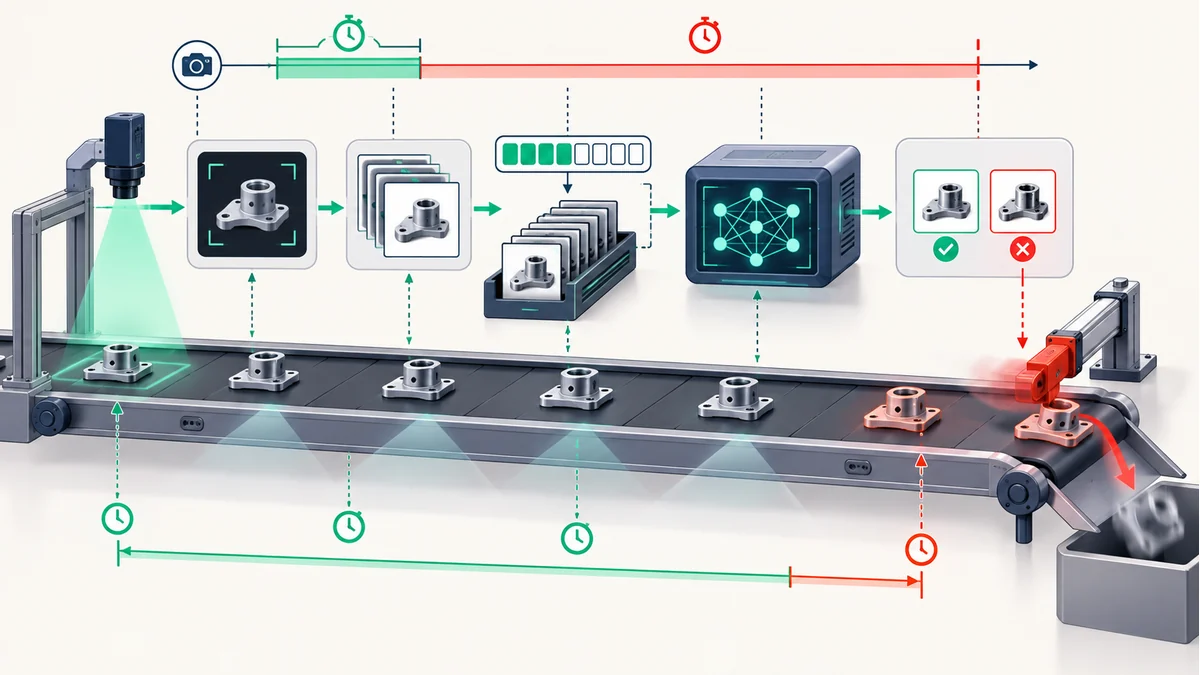
비전 AI 모델은 테스트 이미지에서 높은 정확도를 냈습니다. 한 장을 처리하는 시간도 충분히 짧아 보입니다. 그런데 생산라인에 연결하니 불량품이 배출 장치를 지나간 뒤에야 판정 결과가 도착합니다. 문제는 모델이 틀린 것이 아니라 촬영, 전송, 전처리, 대기열, 추론, 제어 신호까지 합한 시간이 라인의 물리적 마감시간을 넘은 것입니다. 산업용 검사 AI의 성능은 정확도와 함께 제때 행동할 수 있는 판정 비율로 평가해야 합니다.
평균 추론 시간으로는 부족하다
제품이 일정한 간격으로 들어오지 않을 수 있습니다. 라인이 잠시 멈췄다가 재가동되면 이미지가 한꺼번에 도착하고, 여러 카메라가 같은 GPU를 공유하면 요청이 겹칩니다. 한 장을 단독으로 처리할 때의 시간은 대기열을 설명하지 못합니다. 실제 총 지연은 촬영 트리거부터 결과가 PLC나 배출 장치에 도달할 때까지 측정해야 합니다. 평균뿐 아니라 늦은 요청의 분포, 피크 시간대 처리량, 대기열 길이를 함께 봅니다.
마감시간도 서버 응답 시간으로 정의하면 안 됩니다. 제품이 카메라 위치에서 배출 위치까지 이동하는 시간에서 제어 신호 전달, 액추에이터 동작, 안전 여유를 빼야 실제 AI 판정에 쓸 수 있는 시간이 나옵니다. 컨베이어 속도가 변하면 마감시간도 변합니다. 제품 ID와 촬영 시각, 위치 추적을 연결하지 않으면 늦게 도착한 판정이 다음 제품에 잘못 적용될 위험도 있습니다.
대기열은 성능의 조기 경보
처리기가 평균적으로 들어오는 이미지보다 조금 빠르더라도 짧은 피크에 대기열이 길어질 수 있습니다. 대기열이 계속 증가한다면 언제가 되었든 마감시간을 넘습니다. 요청 수, 실제 이미지 수, 모델 실행 횟수를 구분해 측정해야 합니다. 배치 처리에서는 여러 이미지를 한 번에 추론할 수 있어 실행 횟수만 보면 부하를 오해하기 쉽습니다. 전처리·후처리가 CPU에서 병목이면 GPU 사용률이 낮아도 전체 지연은 커집니다.
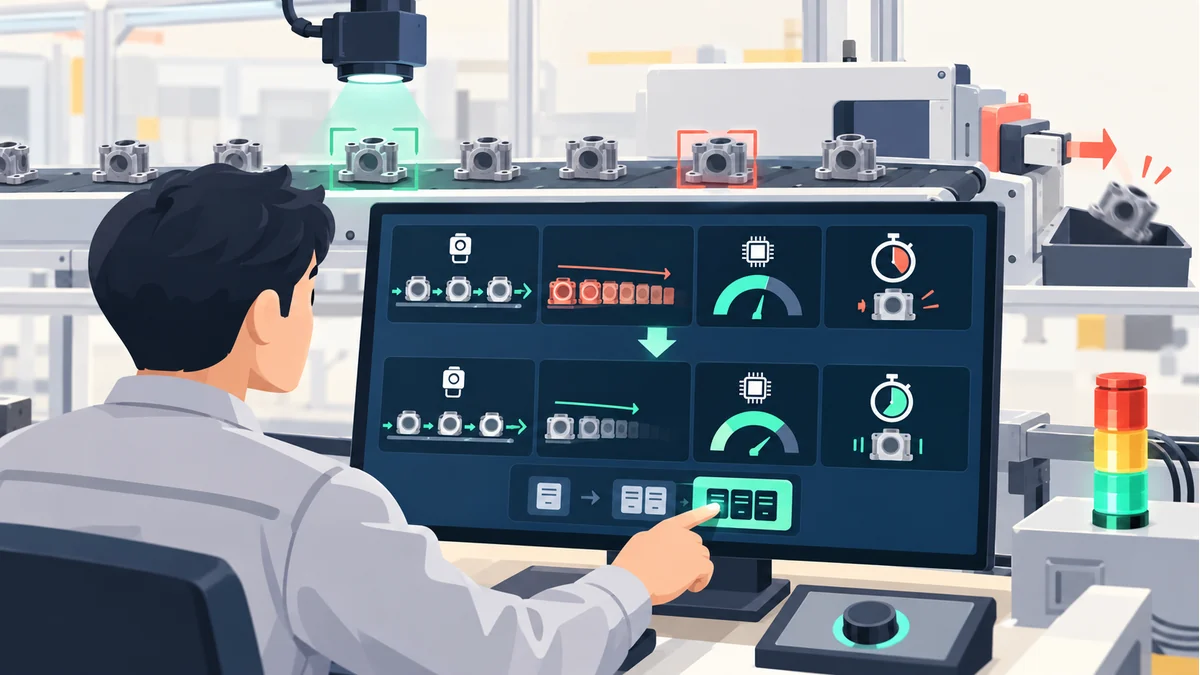
상태 화면에는 입력 속도, 완료 속도, 현재 대기, 마감시간 초과, 이미지 누락, 결과 전달 실패를 나눠 보여주세요. 불량품을 놓친 건과 단순히 늦어서 판정하지 못한 건은 다른 품질 문제입니다. 마감시간을 넘은 결과는 버리지 않고 분석용으로 남길 수 있지만, 생산 제어에는 적용하지 않도록 해야 합니다. 이를 ‘정상’으로 집계하면 실제 검사 커버리지가 과대평가됩니다.
배치와 병렬화에는 대가가 있다
동적 배치는 GPU 처리량을 높일 수 있지만 배치를 모으는 동안 각 요청이 기다립니다. 여유가 적은 고속 라인에서는 배치 크기를 키울수록 결과가 늦어질 수 있습니다. 모델 인스턴스를 늘리면 병렬 처리가 가능하지만 메모리와 장치 용량을 더 사용합니다. 따라서 최적 설정은 ‘초당 몇 장’ 하나로 고르지 말고 실제 도착 패턴에서 마감시간을 지킨 비율과 비용을 비교해야 합니다. 이미지 크기, 동시 카메라 수, 모델 교체 시의 성능 변화도 시험해야 합니다.
처리량이 부족할 때는 모델 경량화만 답이 아닙니다. 촬영 영역을 줄이거나 필요 없는 프레임을 걸러내고, 전처리 병목을 개선하거나 카메라별 자원을 분리할 수 있습니다. 다만 입력을 줄이는 변경은 결함을 놓칠 위험이 있으므로 정확도 검증과 함께 진행해야 합니다. 성능 조정은 AI팀과 설비 제어팀이 공동으로 책임져야 합니다.
놓친 판정의 안전한 처리
마감시간 전에 결과가 오지 않으면 어떻게 할지 현장 정책을 먼저 정합니다. 제품을 자동 보류할지, 라인을 느리게 할지, 수동 재검으로 보낼지 제품과 공정 위험에 따라 다릅니다. 늦은 AI 결과를 무조건 통과로 처리하는 것은 품질 위험을 숨깁니다. 반대로 모든 지연을 불량으로 처리하면 불필요한 폐기가 늘 수 있습니다. 예외 통로와 재검 작업지시, 품질 담당자의 확인 절차를 연결하는 것이 현실적입니다.
NVIDIA의 Triton 추론 서버 지표 문서는 요청·추론·실행 횟수와 대기 시간, 계산 시간을 구분해 보여줍니다. 제품을 쓰지 않더라도 이 구분은 유용합니다. 테스트 이미지 한 장의 속도보다 실제 라인에서 모든 판정이 제때 도착하는지가 산업 AI의 운영 성능입니다.