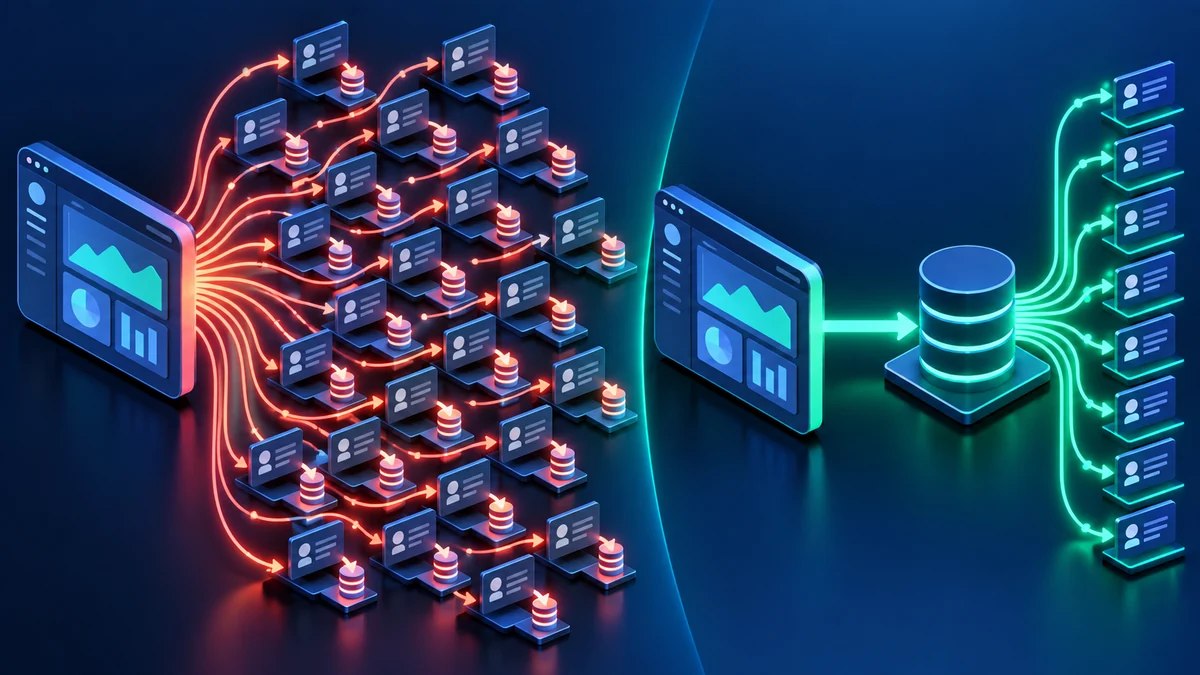
관리자 대시보드에 주문 20건과 각 주문의 고객명·최근 처리 상태를 보여 준다고 해보겠습니다. 화면은 한 번 열었는데 로그에는 SQL이 21번, 때로는 41번 찍힙니다. 첫 쿼리로 주문 목록을 가져온 뒤 루프 안에서 고객이나 상태를 매번 다시 조회하기 때문입니다. 주문이 20건일 때는 참고 넘어갈 수 있지만 200건이 되면 왕복 횟수와 지연이 커집니다. 이것이 흔히 말하는 N+1 조회의 전형적인 모습입니다.
느린 SQL 하나가 아니라 너무 많은 SQL
실행 계획을 보고 개별 쿼리를 최적화했는데도 화면이 계속 느릴 수 있습니다. 각 쿼리가 3ms여도 네트워크 왕복, 커넥션 획득, ORM 객체 생성 비용이 수십 번 반복되기 때문입니다. 먼저 요청 ID 하나에 묶인 SQL 수와 총 DB 시간, 중복된 쿼리 패턴을 봐야 합니다. 목록 크기를 10, 20, 50건으로 늘렸을 때 쿼리 수가 거의 같은 비율로 늘면 의심할 만합니다. 단순히 “응답 시간이 느리다”보다 “한 요청당 쿼리 수가 목록 길이에 비례한다”가 진단에 가깝습니다.
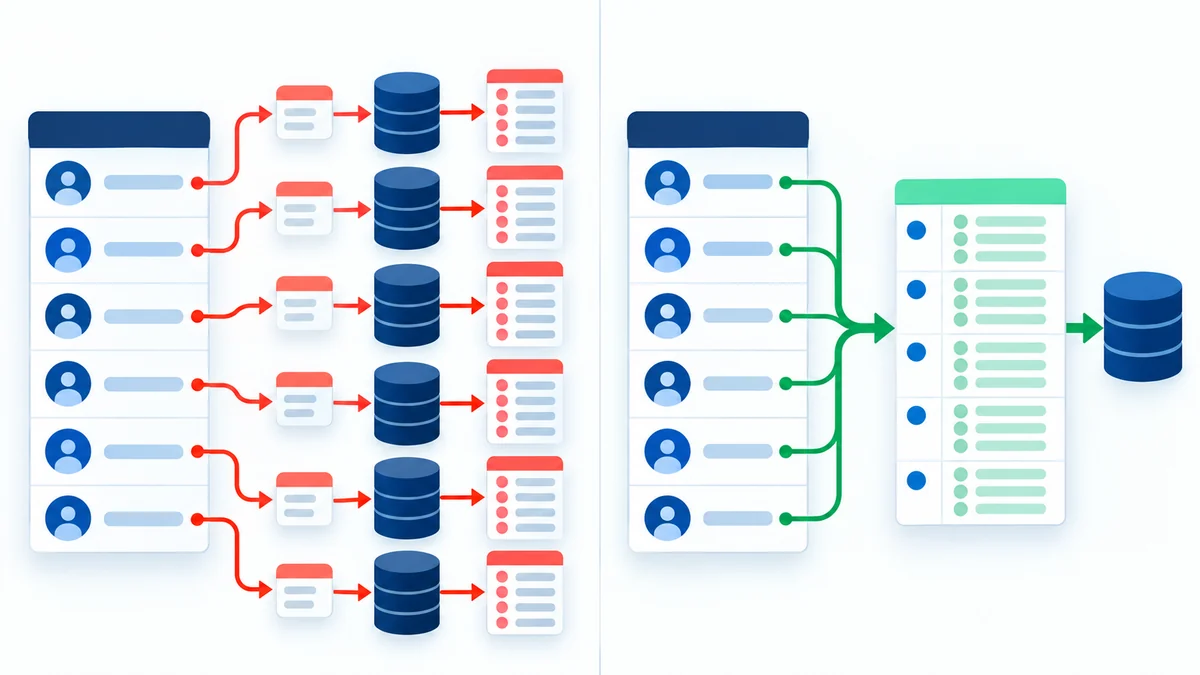
ORM의 지연 로딩은 이런 문제를 숨기기 쉽습니다. 코드에서는 속성 하나를 읽은 것처럼 보이지만 실제로는 매번 데이터베이스에 갔다 옵니다. Microsoft EF Core 성능 문서도 지연 로딩의 추가 왕복과 N+1 위험을 명시합니다. 템플릿 렌더링이나 JSON 직렬화 과정에서 관계 속성이 접근될 수도 있으므로 서비스 코드만 봐서는 놓칠 수 있습니다. SQL 로깅에 요청 식별자를 붙이는 이유입니다.
해결책은 항상 큰 JOIN 한 번이 아니다
단순한 1:1 또는 작은 1:N 관계라면 필요한 열만 선택하는 명시적 조회나 eager loading이 효과적입니다. 하지만 여러 1:N 컬렉션을 한꺼번에 JOIN하면 행이 곱해져 전송량이 폭증할 수 있습니다. 이때는 부모 목록을 가져온 뒤 부모 ID 목록으로 자식 데이터를 한 번에 조회하고 메모리에서 묶는 방식이 낫습니다. 예를 들어 주문 20건의 ID를 모아 관련 상태 20건을 한 쿼리로 가져오면, 요청당 쿼리 수가 목록 크기와 무관하게 거의 일정해집니다. 페이지네이션 범위를 먼저 정하지 않으면 배치 조회도 과도해질 수 있습니다.
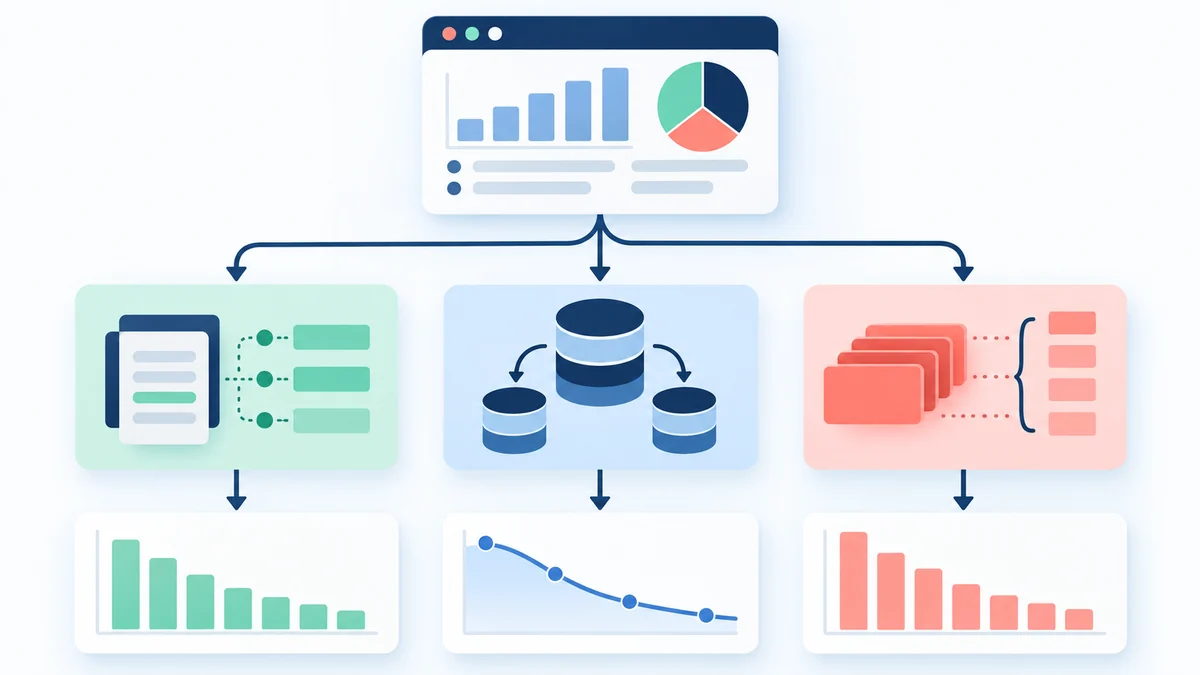
화면이 필요한 것이 “최근 상태 한 건”이라면 모든 상태 이력을 가져올 이유가 없습니다. 그룹별 최신 행을 고르는 쿼리나 별도의 읽기 모델을 고려할 수 있습니다. 자주 바뀌지 않는 참조 데이터는 캐시도 선택지지만, 캐시가 쿼리 설계의 결함을 감추는 도구가 되면 무효화 문제만 늘어납니다. 어떤 방식을 택하든 쿼리 수, 전송 행 수, 응답 p95, DB CPU를 함께 비교해야 합니다.
성능 회귀를 테스트로 막는다
테스트 데이터 2건에서는 N+1이 드러나지 않습니다. 실제 운영 규모를 반영한 목록 크기와 여러 관계가 채워진 데이터를 사용하세요. 한 화면 요청의 쿼리 수에 상한을 두고, 목록 크기를 두 배로 늘려도 쿼리 수가 선형 증가하지 않는지 확인합니다. 모든 요청에 엄격한 동일 숫자를 강제하기보다 핵심 목록 API와 대시보드부터 시작하면 유지하기 쉽습니다. 장애 분석을 위해 SQL 텍스트를 기록할 때는 개인정보와 비밀 매개변수가 로그에 남지 않도록 주의해야 합니다.
실무에서 특히 조심할 부분은 페이지네이션과 정렬 순서입니다. 부모 목록에 LIMIT을 건 뒤 자식 컬렉션을 JOIN하면 예상보다 적은 부모가 보이거나 동일 부모가 중복될 수 있습니다. 반대로 JOIN 결과에 LIMIT을 먼저 적용하면 실제 페이지 경계가 달라질 수 있습니다. 안전한 출발점은 부모 ID 목록을 정해진 정렬 기준으로 먼저 확정하고, 그 ID들에 대한 자식 데이터를 별도로 묶어 가져오는 것입니다. 화면에서 보여 줄 자식 항목의 최대 개수도 함께 정해야 응답 크기가 통제됩니다.
마지막으로 사용자 기준의 확인이 필요합니다. 서버 쿼리 수가 줄었어도 큰 응답을 브라우저에 보내 렌더링이 느려질 수 있습니다. 반대로 SQL 두 번으로 나눴더라도 사용자 체감 시간이 더 짧을 수 있습니다. N+1 해결의 목적은 “쿼리 하나 만들기”가 아니라 데이터 양이 늘어도 예측 가능한 응답 시간을 확보하는 것입니다. 다음에 목록 화면이 느려지면 가장 먼저 요청 하나에 SQL이 몇 번 실행되는지 세어 보세요.