서비스 운영 화면에 고객사별 오류율을 바로 띄우고 싶어 모든 메트릭에 customer_id를 붙였다고 합시다. 기능은 편해 보이지만 어느 날 저장 비용과 쿼리 지연이 함께 늘어날 수 있습니다. 메트릭의 비용은 지표 이름의 개수보다 서로 다른 라벨 값 조합, 즉 카디널리티에 크게 좌우되기 때문입니다.
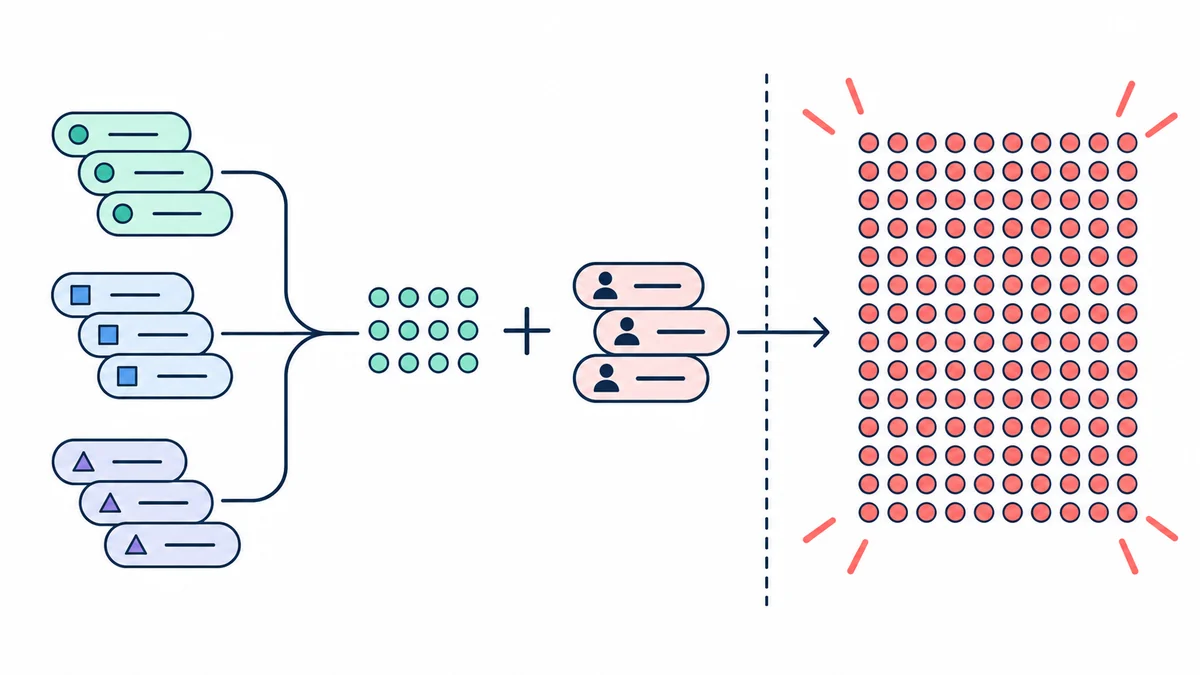
카디널리티는 왜 곱셈이 되는가
요청 수 메트릭에 환경, 서비스, HTTP 결과, 고객사 라벨을 붙이면 각 값의 조합마다 별도의 시계열이 생깁니다. 실제 사용 중인 조합만 생성되므로 단순한 곱이 항상 정확한 청구 금액은 아닙니다. 그래도 고객사 ID나 사용자 ID처럼 값이 계속 늘어나는 속성이 들어오면 시계열 수가 예상보다 빨리 커집니다. 요청 ID는 거의 매번 새로운 값이므로 메트릭 라벨로는 특히 부적합합니다.
카디널리티 문제는 비용만이 아닙니다. 대시보드가 느려지고, 수집기가 메모리 압박을 받으며, 원래 보고 싶었던 전체 오류율의 신호가 희석됩니다. 따라서 “나중에 필터로 쓸지도 모른다”는 이유만으로 모든 속성을 메트릭에 복제하면 안 됩니다.
먼저 질문을 분리한다
운영자가 묻는 질문을 세 종류로 나눠 보세요. “전체 요청의 오류율이 오르는가?”는 집계 메트릭의 영역입니다. “문제가 특정 고객에게만 생겼는가?”는 고객사별 소수 핵심 지표 또는 로그 검색이 적합합니다. “이 요청이 왜 실패했는가?”는 트레이스와 구조화 로그가 답합니다. 모든 질문을 하나의 메트릭으로 해결하려 할 때 비용이 폭발합니다.
메트릭에는 값의 종류가 작고 안정적인 라벨을 우선 사용합니다. 예를 들어 서비스, 배포 환경, 결과 유형, 제한된 오류 분류가 여기에 해당합니다. 동적으로 늘어나는 개별 식별자는 로그나 트레이스 속성으로 보내고, 필요할 때 특정 고객을 조회합니다. 고객사별 실시간 모니터링이 계약상 꼭 필요하다면 전체 메트릭이 아니라 소수의 별도 지표만 허용하고 예상 조합 수에 상한을 둡니다.
특히 경보를 만드는 지표와 장애 조사에 쓰는 지표를 구분하면 선택이 쉬워집니다. 경보는 서비스 전체가 위험한지 빨리 알려야 하므로 안정적인 라벨이 유리합니다. 특정 고객 한 명의 오류를 재구성하는 일은 풍부한 사건 정보를 가진 기록이 적합합니다. 고객사 단위 경보가 꼭 필요한 유료 서비스라면 대상 수, 보존 기간, 샘플링 여부를 제품 요구사항으로 명시하고 비용을 추정해야 합니다. 기술 설정값으로만 숨겨 두면 고객 수가 늘 때 다시 같은 문제가 생깁니다.
실제 계측을 바꾸는 순서
첫째, 현재 메트릭별 고유 시계열 수와 가장 값이 많은 속성을 확인합니다. 둘째, 각 메트릭이 답해야 할 운영 질문을 한 문장으로 적습니다. 셋째, 질문에 불필요한 고객 ID·경로 원문·예외 메시지를 제거합니다. URL은 개별 ID가 포함된 원문 대신 라우트 패턴으로 집계해야 합니다. 넷째, 상세 조사를 위한 상관 ID를 로그와 트레이스에 유지합니다. 다섯째, 변경 전후에 경보가 동일한 사건을 감지하는지 검증합니다.
OpenTelemetry에는 수집 단계의 카디널리티 한계와 초과 처리 개념이 있습니다. 이는 시스템을 보호하는 안전장치이지, 부적절한 라벨 설계를 정당화하는 방법은 아닙니다. 한계에 걸리면 일부 속성별 구분이 사라져 필요한 고객 필터가 동작하지 않을 수 있습니다. 즉 “수집됐으니 괜찮다”가 아니라 “운영 질문에 답할 수 있는가”를 테스트해야 합니다.
작은 팀의 운영 체크리스트
새 계측을 배포하기 전에는 ① 라벨 값이 고정 목록인지 ② 고객·사용자·요청 단위 식별자가 들어가는지 ③ 서비스와 환경이 늘어날 때 조합 수가 얼마인지 ④ 전체 경보에 필요한 집계가 남는지 ⑤ 상세 원인 조사를 로그·트레이스로 이어갈 수 있는지 확인하세요. 비용 지표도 수집량만 보지 말고 활성 시계열 수의 변화를 같이 관찰하는 편이 좋습니다.
좋은 관측성은 모든 차원을 메트릭에 넣는 것이 아닙니다. 빠르게 알아야 할 신호는 작게 집계하고, 자세히 설명해야 할 사건은 검색 가능한 기록에 남기는 역할 분담입니다. 이 경계가 명확하면 대시보드와 비용을 함께 관리할 수 있습니다.