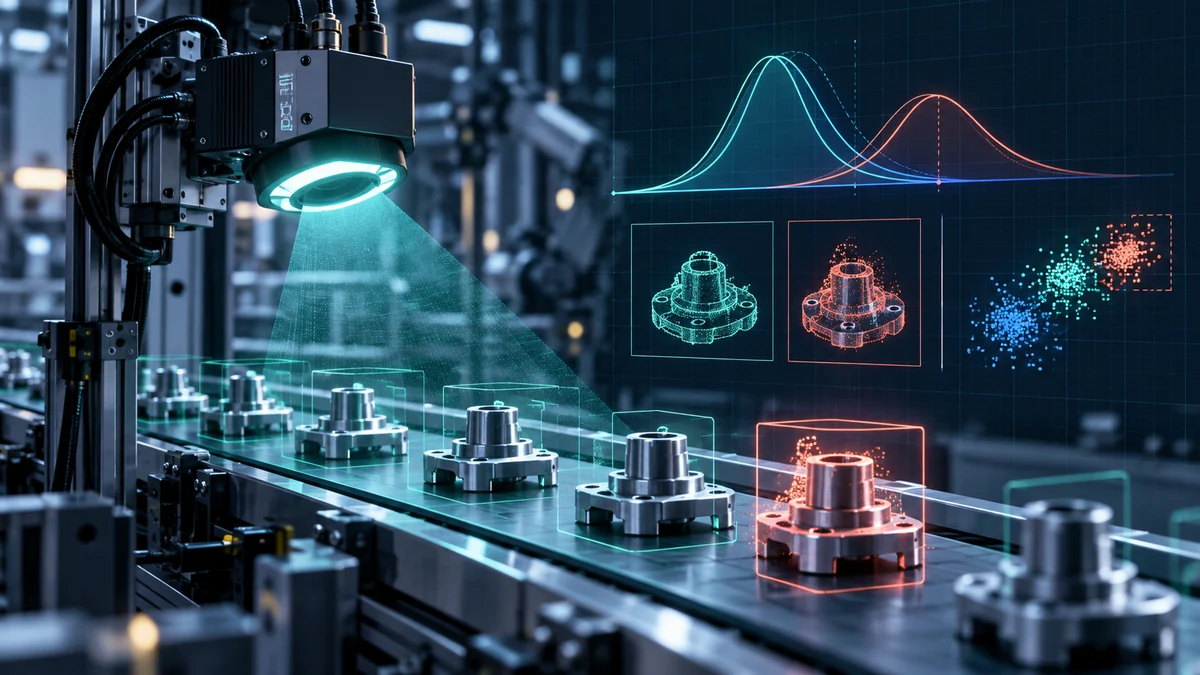
불량 검출 AI를 설치한 뒤 몇 달은 잘 돌아갔습니다. 그런데 조명이 바뀌고 새 자재가 들어오자 현장 담당자가 ‘예전보다 더 놓치는 것 같다’고 합니다. 대시보드는 여전히 모델 서버가 정상이라고 말합니다. 서버의 가용성과 모델의 판단 품질은 다른 문제입니다. 운영 AI에는 입력이 달라졌는지와 실제 판단이 나빠졌는지를 따로 보는 눈이 필요합니다.
드리프트를 하나의 숫자로 뭉치지 않는다
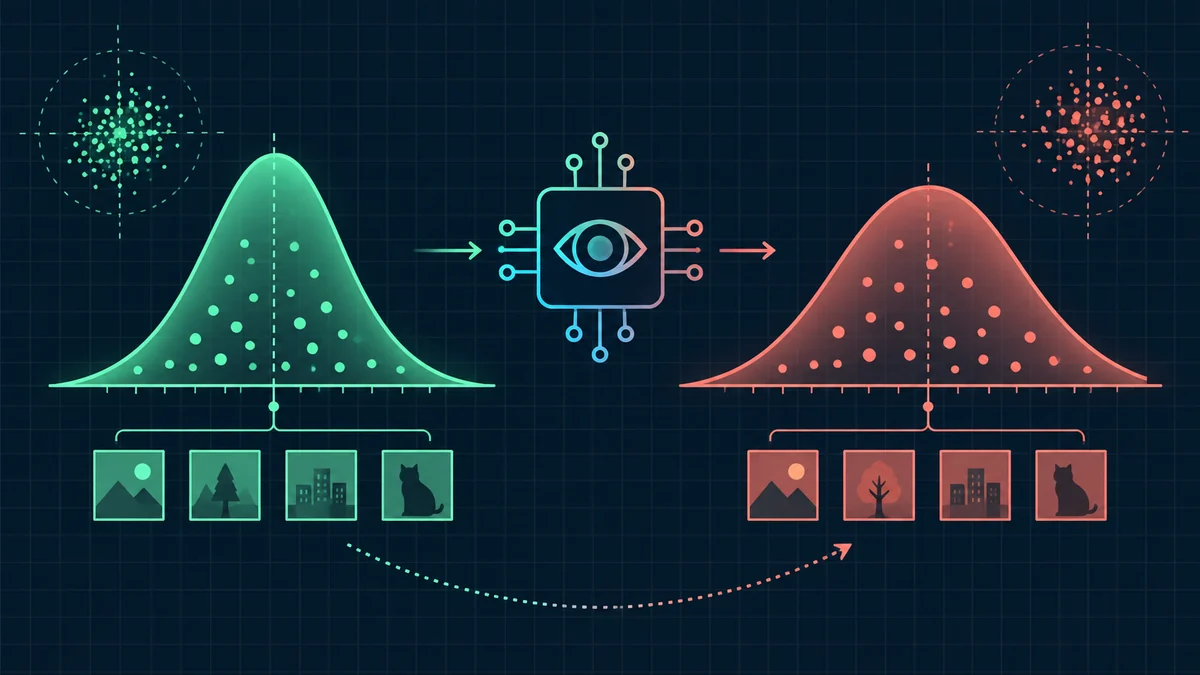
입력 드리프트는 카메라 밝기, 부품 크기, 문서 양식처럼 들어오는 데이터의 분포가 학습 때와 달라지는 일입니다. 개념 드리프트는 같은 입력이라도 정답을 결정하는 관계가 바뀌는 일입니다. 또 스키마 오류, 센서 누락, 날짜 형식 변경은 모델의 학습 문제가 아니라 데이터 파이프라인 문제입니다. 이 셋을 구분해야 대응이 맞습니다.
입력 분포가 달라졌다고 반드시 정확도가 떨어지는 것은 아닙니다. 반대로 전체 분포가 비슷해도 중요한 소수 결함 유형의 성능이 나빠질 수 있습니다. 따라서 분포 경보와 정답 기반 품질 지표를 함께 봅니다. AWS의 MLOps 모니터링 지침도 스키마, 분포, 결측치, 출력과 비즈니스 결과를 구분해 살펴보도록 설명합니다.
먼저 기준선과 관측 단위를 정한다
‘학습 데이터 전체’만 기준으로 삼으면 현장 변화를 해석하기 어렵습니다. 공장, 설비, 카메라, 제품군, 근무조처럼 성능에 영향을 줄 수 있는 단위로 분리해 봅니다. 어떤 단위는 계절에 따라 정상적으로 달라질 수 있습니다. 기준선을 버전으로 관리하고 어떤 모델 버전과 연결되는지 기록해야 합니다.
운영에서는 입력 건수, 결측·형식 오류, 주요 특성의 분포, 예측 점수의 분포, 검토 요청 비율을 우선 수집합니다. 실제 정답이 나중에 들어온다면 예측 시점과 정답 도착 시점을 연결할 식별자도 필요합니다. 그 연결이 없으면 ‘정확도’는 현재 성능이 아니라 오래전 데이터의 숫자가 됩니다.
경보가 떴을 때 조사 순서
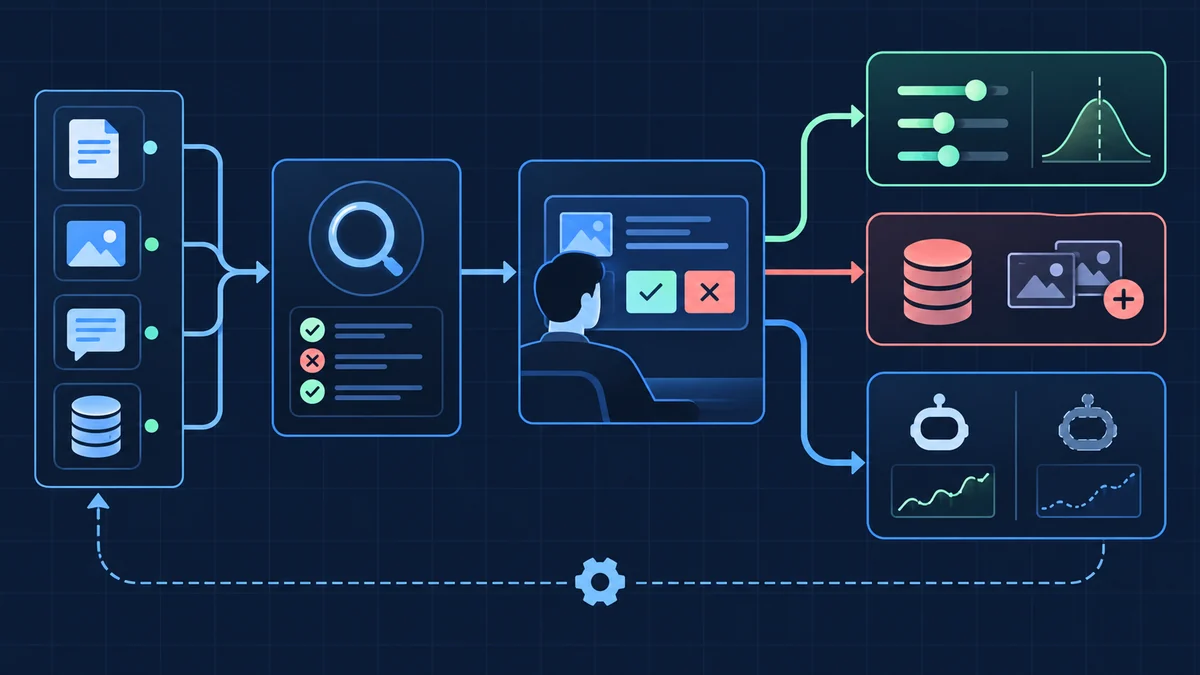
첫째, 수집 경로부터 확인합니다. 카메라 교체, 압축 방식, 단위 변환, 코드 변경이 있었는지 봅니다. 둘째, 달라진 데이터가 특정 설비나 시간대에 몰리는지 확인합니다. 셋째, 사람이 검수한 표본으로 오탐과 미탐을 나눠 봅니다. 넷째, 이 변화가 실제 업무 손실로 이어지는지 확인합니다. 자동화 비율만 좋아도 미탐이 늘었다면 좋은 변화가 아닙니다.
경보 임계값은 모든 특성에 같은 수치를 적용하기보다 업무 영향에 맞춰 정합니다. 중요하지 않은 배경색 변화와 안전에 관련된 결함 특성 변화는 우선순위가 다릅니다. 가능하다면 경보에 ‘무엇이 얼마나 달라졌고, 어떤 업무에 영향을 줄 수 있는지’를 붙여 운영자가 판단하도록 합니다.
재학습은 대응 후보 중 하나다
원인이 조명 설정이면 촬영 환경을 복구하는 편이 먼저일 수 있습니다. 누락된 클래스라면 새 정답 데이터를 수집해야 하고, 결정 임계값 문제라면 운영 정책 조정이 필요할 수 있습니다. 재학습이 필요한 경우에도 새 모델을 즉시 교체하지 말고 대표 사례와 취약 집단의 회귀 평가, 기존 모델과의 그림자 비교, 단계적 전환을 거칩니다.
모델 품질은 AI 팀 혼자 유지할 수 없습니다. 현장이 ‘이 예측은 틀렸다’고 표시할 수 있는 피드백 경로, 정답을 검수할 담당자, 배포를 승인할 책임자가 있어야 합니다. 이를 운영 프로세스로 만들지 않으면 모니터링은 경보를 쌓는 일로 끝납니다.
정답이 늦게 오는 현장에서는 대리지표를 신중히 쓴다
제조 검사에서 실제 불량 여부가 며칠 뒤에 확인된다면 오늘의 정확도를 바로 계산할 수 없습니다. 이때 검토 요청 비율, 사람이 판단을 뒤집은 비율, 특정 설비에서만 늘어난 경보 등을 잠정 신호로 볼 수 있습니다. 다만 대리지표가 안정적이어도 실제 미탐이 증가할 수 있으므로 정답이 들어오는 시점에 뒤늦은 성능 평가를 반드시 연결해야 합니다.
또한 모니터링용 데이터 자체가 편향될 수 있습니다. 사람이 ‘의심스러운 예측’만 검수하면 검수 표본의 오류율을 전체 모델 오류율처럼 보고할 수 없습니다. 무작위 표본과 위험 기반 표본을 구분해 수집하고, 지표에 어떤 표본을 사용했는지 기록합니다. 그래야 모델 변경 전후 비교가 의미를 가집니다.
운영 체크리스트
- 모델·기준선·입력 파이프라인 버전을 함께 기록하는가?
- 분포 변화와 실제 정확도 저하를 구분하는가?
- 공장·설비·제품군 등 중요한 구간별로 보는가?
- 정답이 늦게 오는 경우 예측과 정답을 연결할 수 있는가?
- 촬영 환경 수정, 임계값 조정, 재학습의 선택 기준이 있는가?
#모델드리프트 #데이터드리프트 #모델모니터링 #MLOps #AI운영 #재학습기준 #AI품질 #제조AI #데이터품질 #모델검증