개발 환경에서는 컬럼 이름 하나를 바꾸는 일이 간단해 보입니다. 마이그레이션 파일을 실행하고 애플리케이션 코드를 수정하면 끝입니다. 하지만 운영 환경에는 이미 수천만 건의 데이터가 있고, 여러 버전의 서버가 동시에 요청을 처리하며, 배치 작업과 관리자 도구까지 같은 테이블을 사용합니다.
ALTER TABLE 한 줄이 긴 잠금을 만들거나, 새 코드가 배포되는 동안 구버전 서버가 사라진 컬럼을 읽으면 서비스 전체가 흔들립니다. 마이그레이션은 성공했는데 백필이 DB I/O를 모두 사용해 정상 요청이 느려지는 일도 있습니다.
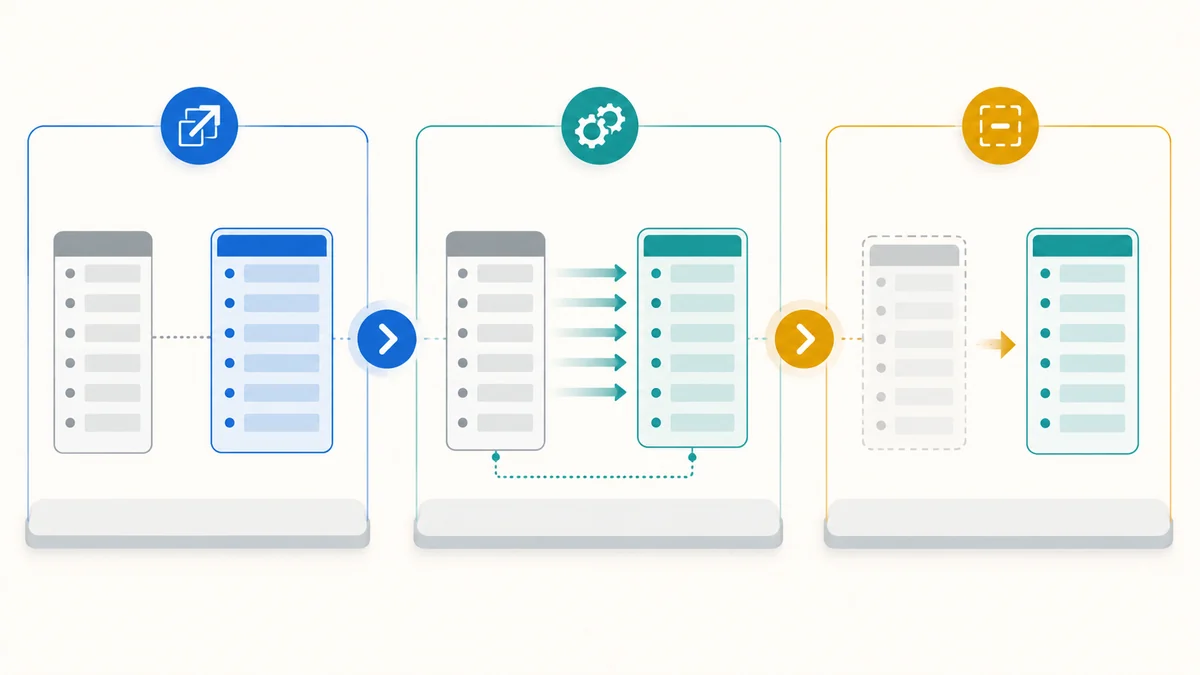
무중단 스키마 변경의 핵심은 SQL 문법이 아니라 시간을 두고 호환성을 이동하는 것입니다. 새 구조를 먼저 추가하고(Expand), 데이터를 옮기며 사용 주체를 전환한 뒤(Migrate), 아무도 쓰지 않는 옛 구조를 제거합니다(Contract). 이번 글에서는 이 과정을 실제 배포 단위로 나눠 살펴봅니다.
왜 애플리케이션 배포와 DB 변경은 동시에 끝나지 않을까
롤링 배포에서는 구버전과 신버전 인스턴스가 일정 시간 함께 실행됩니다. 트래픽 전환이 끝난 뒤에도 지연된 작업, 재시도 메시지, 오래 실행 중인 배치가 구 코드를 사용할 수 있습니다. 따라서 어느 한순간부터 모든 프로세스가 새 스키마만 본다고 가정하면 위험합니다.
예를 들어 users.name을 display_name으로 즉시 변경하면 새 코드는 동작하지만 아직 종료되지 않은 구버전은 컬럼 없음 오류를 냅니다. 반대로 코드부터 바꾸면 새버전이 아직 존재하지 않는 컬럼을 찾습니다. 배포 순서를 바꾸는 것만으로는 공존 구간을 없앨 수 없습니다.
안전한 변경은 각 단계가 이전 버전과 다음 버전 모두에 호환돼야 합니다. 한 번의 거대한 배포가 아니라 되돌릴 수 있는 작은 배포 여러 개로 나누는 이유입니다.
Expand–Migrate–Contract의 세 단계
Expand 단계에서는 기존 동작을 깨지 않으면서 새 컬럼, 새 테이블 또는 새 인덱스를 추가합니다. 기존 컬럼은 그대로 남아 있고 새 구조는 아직 선택 사항입니다.
Migrate 단계에서는 새 코드가 신·구 구조를 함께 다룰 수 있게 만들고, 과거 데이터를 백필하며, 읽기 경로를 새 구조로 전환합니다. 실제 위험과 관측 작업이 가장 많이 몰리는 구간입니다.
Contract 단계에서는 모든 호출자가 옛 구조를 더 이상 사용하지 않는다는 증거를 확인한 뒤 구 컬럼, 호환 코드와 임시 트리거를 제거합니다. 이 단계가 늦어져도 기능은 동작하지만 너무 오래 미루면 이중 구조가 새로운 기술 부채가 됩니다.
예제로 보는 컬럼 이름 변경
customer.full_name을 display_name으로 바꾼다고 가정해 보겠습니다. 단순 rename 대신 다음과 같이 진행합니다.
display_name을 nullable 컬럼으로 추가합니다.- 신버전 애플리케이션이 쓰기 시 두 컬럼을 함께 갱신하게 배포합니다.
- 과거 행의
display_name을 작은 배치로 백필합니다. - 누락과 불일치를 검증한 뒤 읽기를 새 컬럼으로 전환합니다.
- 구버전과 오래된 작업이 사라졌음을 확인합니다.
- 이중 쓰기를 제거하고, 별도 배포에서
full_name을 삭제합니다.
한동안 두 컬럼이 공존하므로 어느 값을 진실로 볼지 규칙이 필요합니다. 전환 초기에는 display_name이 없으면 full_name을 읽는 fallback을 둘 수 있습니다. 백필과 검증이 끝난 뒤에는 fallback 사용 횟수가 0인지 지표로 확인하고 새 컬럼만 읽습니다.
NOT NULL 컬럼은 기본값과 함께 바로 추가하지 않는다
큰 테이블에 NOT NULL 컬럼과 기본값을 한 번에 추가하면 DB 종류와 버전에 따라 테이블 전체 재작성, 긴 메타데이터 잠금 또는 복제 지연이 발생할 수 있습니다. 최신 DB가 이를 빠르게 최적화하더라도 운영 환경의 정확한 버전과 실행 계획을 먼저 확인해야 합니다.
보수적인 순서는 nullable 컬럼 추가, 새 행에 값을 쓰는 코드 배포, 기존 행 백필, 누락 검증, 마지막으로 제약 추가입니다. 제약 검증을 별도 단계로 수행할 수 있는 DB라면 먼저 새 데이터에만 적용하고 기존 데이터 검사를 나중에 실행하는 방법도 있습니다.
기본값은 데이터 의미도 고려해야 합니다. 모든 과거 주문의 통화가 실제로 원화라는 보장이 없는데 빈칸을 KRW로 채우면 기술적으로는 마이그레이션에 성공해도 업무 데이터는 틀립니다. 백필 규칙은 제품·도메인 담당자와 합의해야 합니다.
이중 쓰기는 짧고 명시적으로 운영한다
마이그레이션 동안 애플리케이션이 구 컬럼과 신 컬럼에 모두 쓰는 방식을 dual write라고 합니다. 동일 DB의 한 트랜잭션에서 두 컬럼을 갱신하면 원자성을 확보하기 쉽지만, 여러 코드 경로가 직접 SQL을 실행한다면 누락될 수 있습니다.
쓰기 경로를 서비스 계층 하나로 모으고, 관리 도구·배치·데이터 수정 스크립트까지 목록화합니다. 이중 쓰기 실패를 조용히 무시하면 백필이 끝난 뒤에도 새 불일치가 계속 생깁니다. 두 값의 차이를 측정하는 검증 쿼리와 지표를 함께 배포해야 합니다.
DB 트리거로 동기화하면 오래된 호출자까지 포괄할 수 있지만 숨은 동작이 생기고 쓰기 부하와 디버깅 난도가 높아집니다. 트리거를 사용한다면 임시 장치임을 명확히 하고 제거 조건과 담당자를 기록합니다.
읽기 전환은 기능 플래그로 점진적으로 진행한다
새 컬럼이 추가됐다고 모든 읽기를 즉시 바꿀 필요는 없습니다. 먼저 내부 사용자나 소량 트래픽에서 새 읽기 경로를 활성화하고 결과를 비교할 수 있습니다. 구 값과 신 값이 다르면 사용자 응답은 아직 구 값을 사용하되 로그와 지표로 차이를 수집하는 shadow read도 유용합니다.
비교 시 문자열 공백, 시간대, 반올림 같은 정규화 차이를 실제 오류와 구분해야 합니다. 단순 바이트 비교가 아니라 업무적으로 동일한지를 판단하는 검증기가 필요합니다.
전환 플래그는 서버별 메모리에만 두지 말고 일관된 설정 시스템에서 관리합니다. 롤백할 때 DB를 되돌리기보다 읽기 경로를 구 컬럼으로 돌릴 수 있으면 복구가 빠릅니다. 단, 새 코드가 구 컬럼 쓰기를 이미 중단했다면 롤백 데이터가 최신인지 확인해야 합니다.
백필은 데이터 복사가 아니라 운영 트래픽과 경쟁하는 작업이다
수천만 행을 한 번의 UPDATE로 바꾸면 긴 트랜잭션, 로그 폭증, 락 대기, 버퍼 캐시 오염과 복제본 지연이 생길 수 있습니다. 정상 요청이 사용하는 DB 자원을 백필이 모두 가져가면 무중단 마이그레이션이라는 목표를 잃습니다.
백필은 기본키 범위나 생성 시각을 기준으로 작은 배치로 나눕니다. 각 배치 이후 커밋하고 진행 위치를 체크포인트에 저장합니다. 작업이 중단돼도 처음부터 다시 시작하지 않으며, 같은 배치를 반복해도 결과가 같은 멱등 연산으로 만듭니다.
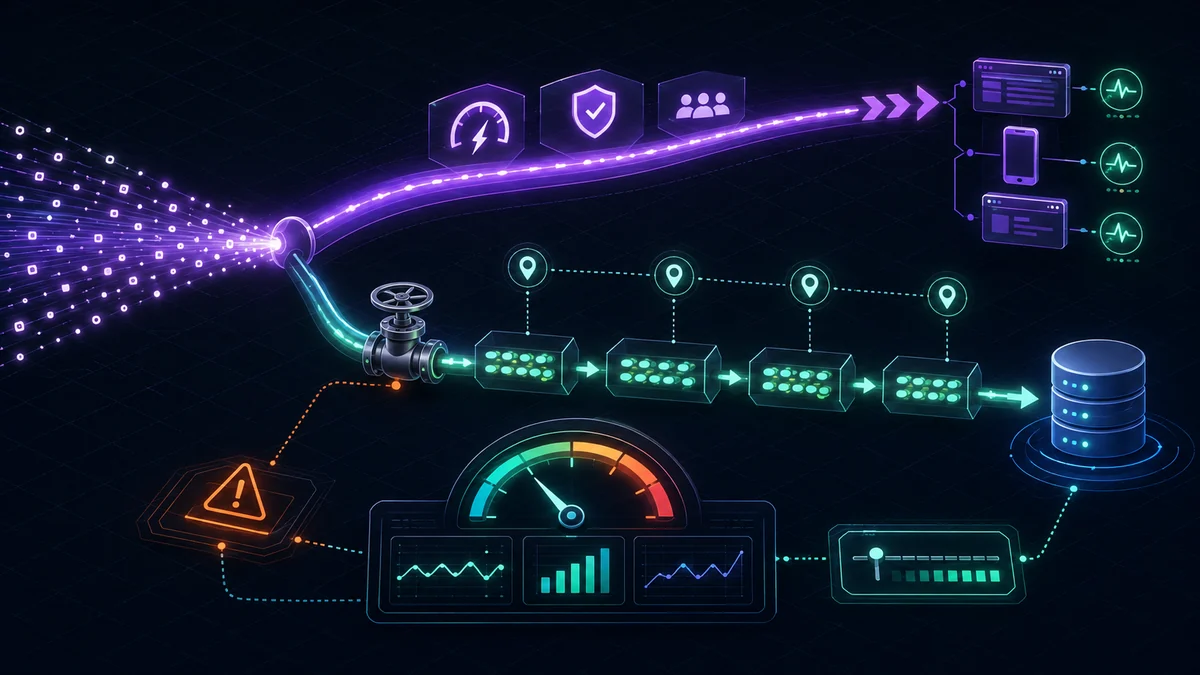
배치 크기와 대기 시간은 고정값보다 DB 상태에 따라 조절하는 편이 좋습니다. CPU, IOPS, 락 대기, p95 쿼리 지연, 복제 lag가 임계치를 넘으면 속도를 낮추거나 멈춥니다. 피크 시간대에는 일시 정지하고 여유 시간에 다시 시작할 수도 있습니다.
백필 쿼리는 인덱스를 탈 수 있어야 한다
WHERE new_column IS NULL 조건만 반복하면 매 배치마다 큰 테이블을 스캔할 수 있습니다. 기본키 커서를 함께 사용해 id > last_id ORDER BY id LIMIT n 형태로 진행하면 범위를 예측하기 쉽습니다. 단, 작업 도중 새 행이 들어오는 경우를 dual write가 처리하고 있는지 확인합니다.
백필을 위해 임시 인덱스를 추가할 수도 있지만 인덱스 생성 자체가 큰 작업입니다. 온라인 인덱스 기능, 추가 디스크 공간, 쓰기 증폭과 복제 영향까지 계산해야 합니다. 완료 후 임시 인덱스를 제거하는 작업도 Contract 목록에 넣습니다.
한 행을 읽고 애플리케이션에서 계산한 뒤 다시 쓰는 방식은 유연하지만 네트워크 왕복이 많습니다. SQL로 안전하게 표현 가능한 변환은 DB 내부 배치 업데이트가 효율적이고, 복잡한 업무 로직이나 외부 데이터가 필요하면 작업자 기반 처리가 적절할 수 있습니다.
테이블 분리와 관계 변경은 중간 모델이 필요하다
컬럼 이름 변경보다 어려운 사례는 한 테이블을 둘로 나누거나 1:N 관계를 추가하는 것입니다. 예를 들어 orders.shipping_address 문자열을 주소 테이블과 외래키로 바꾼다면 새 테이블 생성, 주소 레코드 생성, 외래키 백필, 신·구 쓰기 동기화가 필요합니다.
중간 단계에서 애플리케이션은 새 관계가 없을 때 구 문자열을 읽을 수 있어야 합니다. 새 주소를 먼저 만들고 주문 외래키를 갱신하는 두 작업이 같은 DB라면 한 트랜잭션으로 묶습니다. 데이터베이스가 다르다면 Outbox나 보상 처리처럼 분산 일관성 전략이 별도로 필요합니다.
외래키도 큰 테이블에 즉시 검증하면 오래 걸릴 수 있습니다. 새 쓰기에 대해 먼저 관계를 강제하고 기존 데이터는 온라인 방식으로 검증할 수 있는지 확인합니다. 고아 레코드를 어떻게 수정할지 결정하지 않은 채 제약부터 켜면 마이그레이션이 중단됩니다.
인덱스 변경은 실행 계획 전환까지 포함한다
새 인덱스를 만들었다고 쿼리가 자동으로 더 빨라진다고 보장할 수 없습니다. 통계 정보, 데이터 분포와 파라미터에 따라 옵티마이저가 다른 계획을 선택할 수 있고, 인덱스 생성 중 CPU와 I/O가 증가합니다.
운영 DB가 제공하는 온라인 또는 concurrent 인덱스 생성 방식을 사용하되 이 기능도 완전히 무부하는 아닙니다. 생성 전 여유 공간과 장시간 트랜잭션을 확인하고, 생성 후 실제 쿼리 계획과 지연 분포를 비교합니다.
구 인덱스 제거도 Contract 단계입니다. 사용되지 않는다고 추정하기보다 쿼리 통계와 충분한 관찰 기간을 근거로 판단합니다. 롤백된 구버전이 해당 인덱스에 의존할 가능성이 사라진 뒤 삭제합니다.
락은 실행 시간보다 획득 시간이 더 위험할 수 있다
일부 DDL은 실제 작업이 빠르더라도 메타데이터 락을 얻기 위해 오래 기다립니다. 그동안 뒤에 온 정상 쿼리까지 줄지어 막힐 수 있습니다. “스테이징에서 0.1초 걸렸다”는 결과가 운영 안전성을 보장하지 않는 이유입니다.
짧은 lock timeout과 statement timeout을 설정해 즉시 실패하도록 하고, 실패하면 애플리케이션 요청을 막기 전에 다음 창에서 재시도합니다. 배포 도구가 DDL 실패를 무한 재시도하지 않게 해야 합니다. 실행 전에 장기 트랜잭션, 복제 상태와 현재 락 대기를 확인합니다.
DB 엔진과 버전에 따라 같은 DDL의 동작이 크게 다르므로 일반적인 문서만 믿지 말고 운영과 동일한 버전, 유사한 데이터 크기에서 리허설합니다. 실제 테이블 통계와 트래픽 패턴을 복제할수록 예측력이 높아집니다.
롤백은 스키마 삭제가 아니라 호환 경로 복귀다
데이터를 변환한 뒤 즉시 역변환하는 것은 어렵거나 정보 손실을 만들 수 있습니다. 운영 중 롤백의 첫 선택은 DDL 역실행이 아니라 새 기능을 끄고 구버전이 여전히 이해하는 구조로 트래픽을 되돌리는 것입니다.
그래서 Expand와 Migrate 동안 구 컬럼을 유지합니다. 신·구 쓰기가 동기화되고 있다면 애플리케이션 롤백이 가능합니다. 새 형식에서만 표현되는 데이터가 생기기 전에 호환성 범위를 명확히 해야 합니다.
Contract는 되돌리기 어려운 단계입니다. 컬럼 삭제 전 백업이 있다는 사실만으로 안심하지 말고 복원에 필요한 시간과 서비스 영향을 계산합니다. 대부분은 삭제를 한두 번의 릴리스 더 늦추는 편이 훨씬 저렴합니다.
마이그레이션 상태를 코드와 함께 관측한다
“백필 87% 완료”만으로는 부족합니다. 다음 지표를 함께 봐야 합니다.
- 구·신 컬럼의 불일치 건수와 최근 발생률
- 구 컬럼 fallback 읽기 횟수
- 백필 처리 속도, 남은 예상 시간과 실패 배치
- DB CPU·IOPS·락 대기·쿼리 p95/p99 지연
- 복제본 lag와 트랜잭션 로그 증가량
- 신·구 애플리케이션 버전별 오류율
마이그레이션 ID를 로그와 배포 기록에 남기면 특정 시점의 지연이 어떤 백필이나 DDL과 연관됐는지 찾기 쉽습니다. 대시보드와 중지 기준을 작업 전에 준비해야 문제가 생겼을 때 감으로 판단하지 않습니다.
자동 배포 파이프라인에서 지켜야 할 규칙
마이그레이션 파일은 순서가 보장되고 한 번만 적용돼야 합니다. 이미 적용된 파일을 수정하기보다 새 파일로 보정하며, 실행 이력을 DB에 기록합니다. 여러 인스턴스가 동시에 시작될 때 모두 마이그레이션을 실행하지 않도록 전용 작업 단계나 리더 잠금을 둡니다.
애플리케이션 시작 시 무거운 DDL을 자동 실행하면 새 버전 배포와 DB 위험이 한 번에 결합됩니다. 빠르고 호환 가능한 Expand DDL도 운영 정책에 따라 별도 승인·관측 단계로 분리할 수 있습니다. 대규모 백필은 특히 웹 서버 시작 과정이 아니라 독립 작업으로 운영합니다.
CI에서는 이전 버전 스키마에서 최신 버전까지 실제 마이그레이션하고, 새로 생성한 최신 스키마와 구조가 같은지 비교합니다. 롤링 배포 테스트에서는 구버전과 신버전 애플리케이션이 확장된 스키마에서 동시에 동작하는지도 확인합니다.
실전 배포 순서
- 사전 조사: 모든 읽기·쓰기 주체, 테이블 크기, 장기 트랜잭션과 복제 구조를 파악합니다.
- Expand: 호환 가능한 nullable 컬럼이나 새 테이블을 온라인 방식으로 추가합니다.
- 호환 코드 배포: 이중 쓰기와 fallback 읽기, 비교 지표를 활성화합니다.
- 백필: 작은 멱등 배치와 체크포인트로 과거 데이터를 이동합니다.
- 검증: 누락·불일치·성능·복제 지연이 기준 안인지 확인합니다.
- 읽기 전환: 소량부터 새 구조를 사용하고 단계적으로 확대합니다.
- 구 경로 중단: 모든 인스턴스와 작업이 새 구조만 쓰도록 배포합니다.
- 관찰 기간: fallback과 구 컬럼 접근이 0인지 충분히 지켜봅니다.
- Contract: 구 컬럼, 임시 코드·트리거·인덱스를 별도 변경으로 제거합니다.
설계 리뷰 체크리스트
- 신·구 애플리케이션이 동시에 확장된 스키마를 사용할 수 있는가?
- DDL의 락 방식과 운영 DB 버전에서의 실행 특성을 확인했는가?
- 백필을 중단하고 재개해도 데이터가 중복되거나 깨지지 않는가?
- 백필이 정상 트래픽을 보호하도록 속도 제한과 중지 기준이 있는가?
- 모든 쓰기 경로가 신·구 데이터를 함께 갱신하는가?
- 읽기 전환을 기능 플래그로 되돌릴 수 있는가?
- 데이터 일치 여부를 샘플이 아닌 지표와 검증 쿼리로 확인하는가?
- 구 스키마를 제거해도 되는 조건과 관찰 기간이 정해져 있는가?
- 복원 시간까지 포함한 롤백 계획을 리허설했는가?
마무리: 무중단 변경은 속도보다 호환성의 기술이다
운영 데이터베이스의 스키마 변경은 한 번에 빨리 끝내는 작업이 아닙니다. 새 구조를 추가하고, 여러 버전이 함께 작동하는 시간을 견디며, 데이터를 천천히 옮기고, 충분한 증거가 생긴 뒤 옛 구조를 제거하는 변화 관리입니다.
Expand–Migrate–Contract는 변경 횟수를 늘리지만 각 단계의 위험과 롤백 범위를 줄입니다. 이중 쓰기와 fallback은 영구 구조가 아니라 안전한 다리이고, 온라인 백필은 배치 속도보다 정상 트래픽 보호가 우선입니다.
가장 안전한 마이그레이션은 “실패하지 않는 한 번의 실행”이 아니라, 어느 단계에서 멈춰도 서비스가 계속되고 다시 시작할 수 있는 과정입니다. 이 기준을 배포 문화에 넣으면 데이터 규모가 커져도 스키마 변경을 특별한 야간 작업이 아닌 반복 가능한 엔지니어링으로 바꿀 수 있습니다.