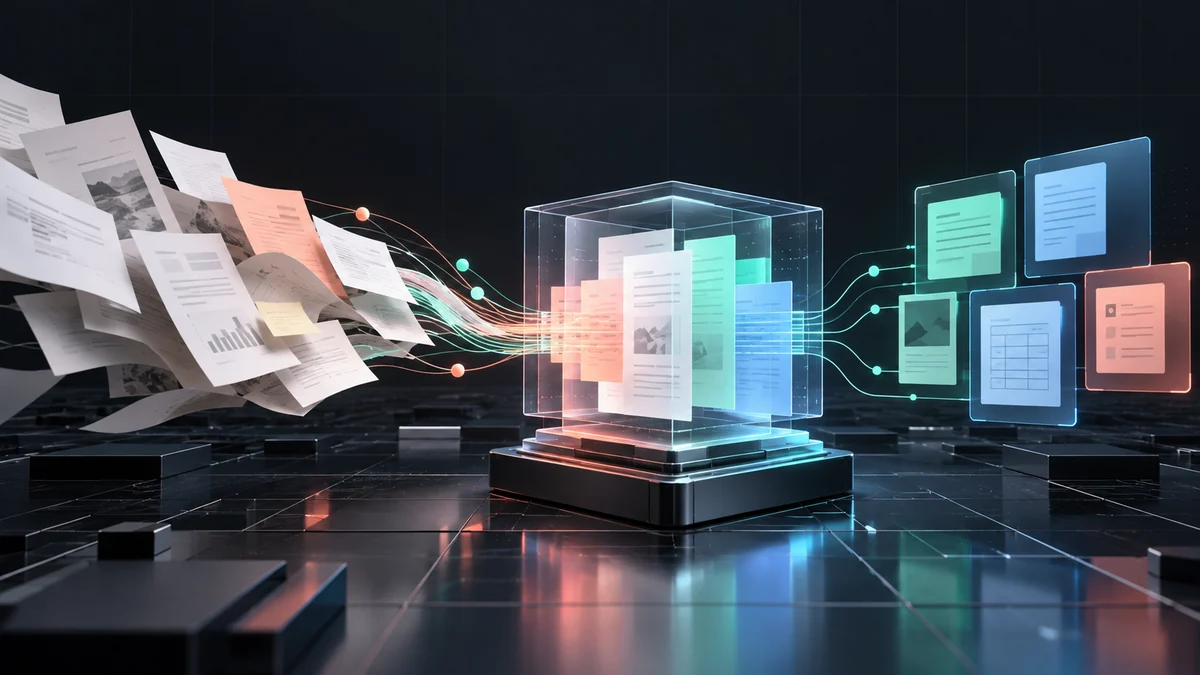
OCR 오인식을 줄이는 사람 검수와 재학습 루프
OCR 모델이 문자를 잘 읽어도 모든 서류가 자동 처리 가능한 것은 아닙니다. 도장, 손글씨, 표 구조, 촬영 각도 때문에 중요한 필드가 틀릴 수 있습니다. 검수자를 마지막 방어선으로만 두지 말고 오류를 학습 데이터로 되돌리는 흐름이 필요합니다.
NOTES
모델을 만들고, 웹과 앱을 짓고, 업무를 자동화하며 확인한 것을 기록합니다. 통한 방법만이 아니라 통하지 않았던 시도까지 남깁니다.
TOTAL 288
OCR 모델이 문자를 잘 읽어도 모든 서류가 자동 처리 가능한 것은 아닙니다. 도장, 손글씨, 표 구조, 촬영 각도 때문에 중요한 필드가 틀릴 수 있습니다. 검수자를 마지막 방어선으로만 두지 말고 오류를 학습 데이터로 되돌리는 흐름이 필요합니다.
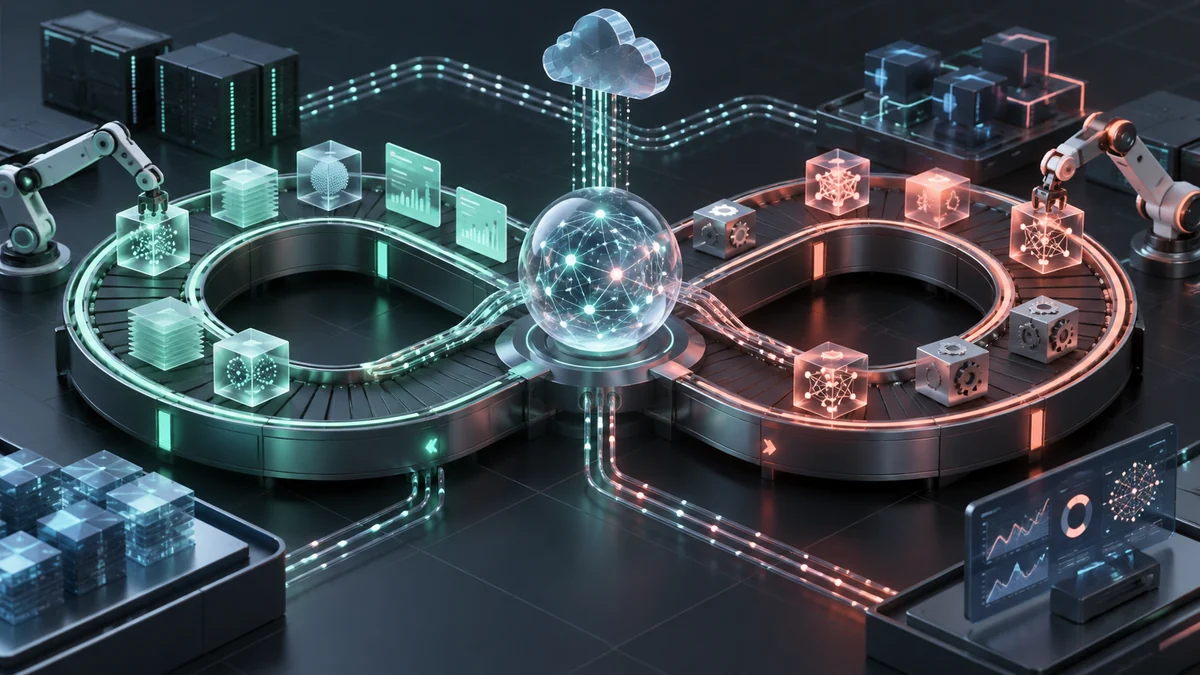
새 모델이 오프라인 평가에서 더 높은 점수를 받았다고 즉시 운영 모델을 바꾸면, 실제 입력 분포와 지연시간 때문에 예상 밖의 문제가 생길 수 있습니다. 섀도 배포는 사용자 응답은 기존 모델이 맡고 새 모델은 같은 요청을 뒤에서 평가하는 방법입니다.
RAG가 답변 끝에 링크를 붙였다고 해서 출처가 오래도록 유효한 것은 아닙니다. 원문이 수정되거나 삭제되면 어제의 정답이 오늘은 잘못된 안내가 될 수 있습니다. 출처를 생성 순간의 장식이 아닌 관리 대상 데이터로 봐야 합니다.
AI 에이전트가 문서를 읽고 API를 호출할 수 있게 되면, 답변 품질만으로는 안전을 설명할 수 없습니다. 중요한 것은 모델이 어떤 도구를 언제, 누구의 권한으로 실행할 수 있는가입니다.
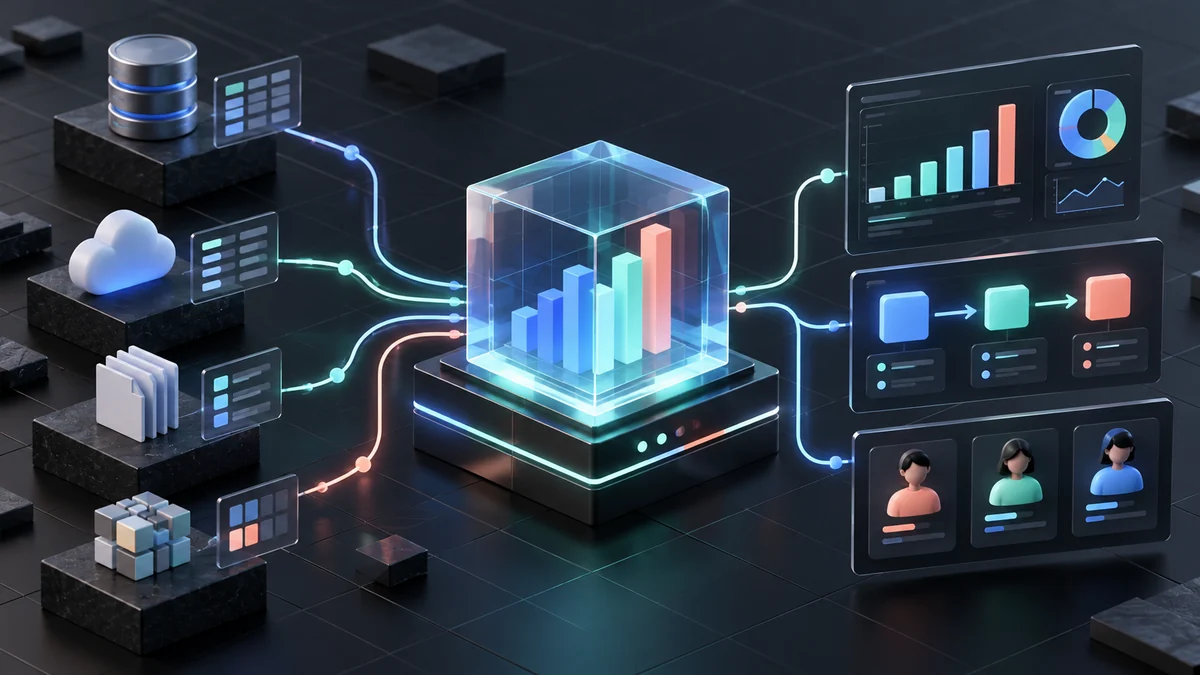
대시보드의 '활성 고객' 숫자가 회의마다 다르게 해석되면 그래프가 아무리 정확해도 의사결정이 흔들립니다. 고객이 로그인한 사람인지, 결제 중인 회사인지, 최근 사용량이 있는 계정인지 정의가 달라서입니다. 지표마다 정의와 책임자를 연결해야 합니다.
현장에서 촬영한 대용량 파일을 올리다 연결이 끊기면 처음부터 다시 보내야 할까요? 파일이 클수록 반복 업로드는 시간과 데이터 사용량을 늘립니다. 청크별 진행 위치를 확인하고 이어 보내는 경로를 설계할 수 있습니다.
상품 검색에서 필터를 여러 개 선택했더니 결과가 0건입니다. 사용자는 어떤 조건이 문제인지 모르면 검색을 처음부터 다시 시작해야 합니다. 0건 화면은 막다른 길이 아니라 조건을 조정할 수 있는 안내가 되어야 합니다.
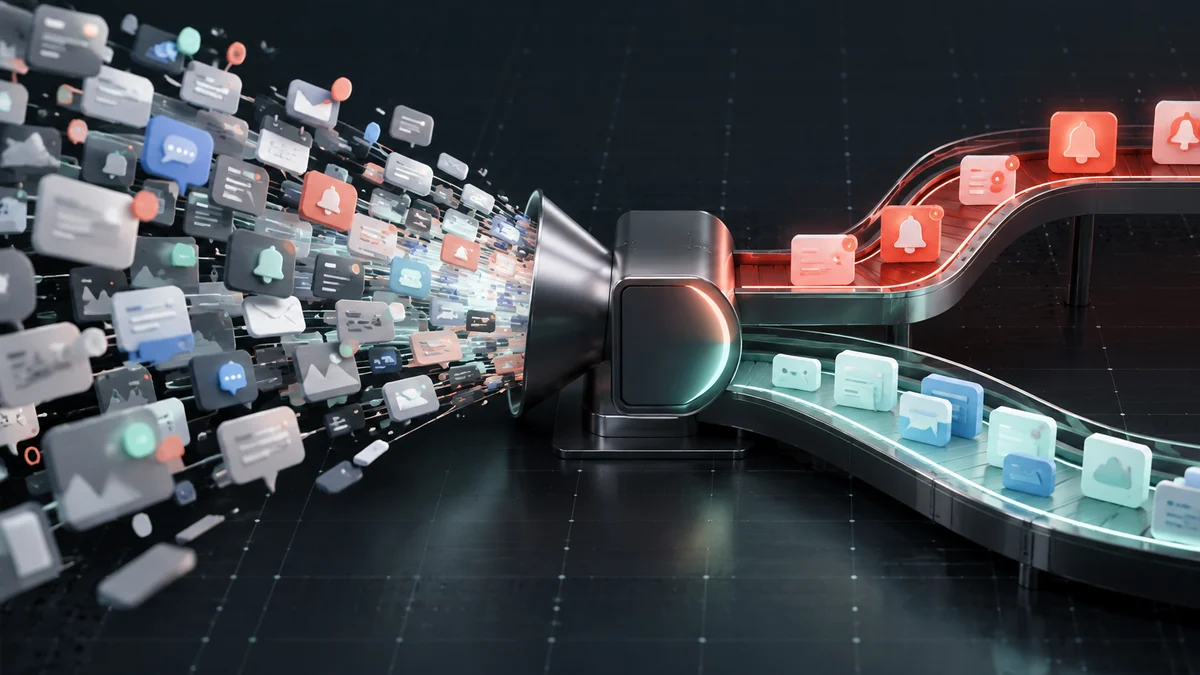
같은 장애 알림이 짧은 시간에 여러 번 오면 사용자는 알림을 무시하기 시작합니다. 모든 알림을 하나로 묶으면 긴급 신호까지 늦어질 수 있습니다. 중요도와 행동 필요성을 기준으로 즉시 알림과 묶음 알림을 나눠야 합니다.
현장 앱에서 오프라인으로 작업 내용을 고친 뒤 연결이 돌아왔습니다. 그 사이 사무실 사용자가 같은 기록을 수정했다면 어느 쪽이 최신일까요? 단순히 마지막 전송 시각으로 덮어쓰면 중요한 메모가 사라질 수 있습니다. 충돌을 감지하고 업무 기준으로 해결해야 합니다.